import dnnlpy
import matplotlib.pyplot as plt
import numpy as np
import torch

dnnlpy.set_matplotlib_format('svg')
print('PyTorch version:', torch.__version__)
PyTorch version: 2.14.0+cpu
上一节我们把训练显存拆成了 parameters、gradients、optimizer states 和 activations。知道显存花在哪里以后,接下来还有一个很自然的问题:
为什么有些算子 FLOPs 很高,却跑得很快;有些算子 FLOPs 明明很低,却还是占了不少时间?
一个常见的误区是:看到一个 operator 的计算量很大,就直接认为它一定很慢。但 GPU 执行一个算子时,不只是做加法和乘法。数据还要在 HBM、cache、shared memory 和 registers 之间移动:

如果一个算子需要做大量计算,并且同一份数据可以被反复利用,那么它可能主要受 GPU 计算能力限制;反过来,如果一个算子只做很少的计算,却需要不断从 HBM 读取数据、再把结果写回 HBM,那么真正限制它的往往不是 FLOPs,而是 memory bandwidth。
因此,分析一个算子的性能时,至少需要同时看三个东西:
这三个量连起来以后,就得到一个非常重要的性能分析工具:Roofline Model。
这一节的目标不是精确预测某个 kernel 会运行多少微秒,而是建立一套判断方法:
一个算子更可能受 compute 限制,还是受 memory bandwidth 限制?
import dnnlpy
import matplotlib.pyplot as plt
import numpy as np
import torch
dnnlpy.set_matplotlib_format('svg')
print('PyTorch version:', torch.__version__)PyTorch version: 2.14.0+cpuFLOP 是 Floating-Point Operation,表示一次浮点运算。例如 \(a+b\) 可以看作 1 FLOP,而 \(a\times b+c\) 通常可以按一次乘法和一次加法计算为 2 FLOPs。实际讨论神经网络时,我们经常用 FLOPs 表示整个算子的浮点运算总量。
以矩阵乘法
\[ C = AB \]
为例,其中:
\[ A\in\mathbb{R}^{M\times K}, \qquad B\in\mathbb{R}^{K\times N} \]
输出矩阵 \(C\) 有 \(MN\) 个元素,每个元素大约需要 \(K\) 次乘法和 \(K\) 次加法,因此总计算量近似为:
\[ \text{FLOPs} \approx 2MKN \]
如果 \(M=N=K=4096\),那么一次矩阵乘法的计算量约为:
\[ 2\times 4096^3 \approx 1.37\times 10^{11} \text{ FLOPs} \]
也就是大约 137 GFLOPs。
这个数字很大,但它仍然不能直接告诉我们运行时间。原因很简单:
FLOPs 描述的是工作量,不是硬件完成这些工作的速度。
假设 GPU 的峰值计算吞吐量是 \(P_{\text{peak}}\) FLOP/s,那么即使完全忽略 memory、kernel launch 和其他开销,计算时间也只能得到一个理想下界:
\[ T_{\text{compute}} \ge \frac{\text{FLOPs}}{P_{\text{peak}}} \]
但 GPU 不可能凭空完成这些计算。输入数据必须到达计算单元,结果也需要重新写回 memory。因此,只看 FLOPs 仍然是不够的,我们还需要第二个量:Memory Traffic。
考虑一个最简单的 elementwise addition:
\[ z = x + y \]
如果 \(x, y, z\) 都是 BF16,那么每个元素大约需要:
read x:    2 bytes
read y:    2 bytes
write z:   2 bytes
------------------
total:     6 bytes
而真正的计算只有 1 FLOP。也就是说,为了做一次非常简单的加法,我们至少要搬动大约 6 bytes 数据。
对于包含 \(N\) 个元素的 tensor,我们可以粗略估计 memory traffic:
\[ \text{Memory Traffic} \approx 6N\text{ Bytes} \]
假设 GPU 的 HBM bandwidth 是:
\[ B_{\text{peak}}\text{ Bytes/s} \]
那么仅从 memory bandwidth 看,运行时间同样存在一个下界:
\[ T_{\text{memory}} \ge \frac{\text{Bytes moved}}{B_{\text{peak}}} \]
这里讨论的 memory traffic 通常主要指 HBM / global memory 与片上存储之间的数据传输。
这和一个 tensor 占多少显存不是同一件事。例如一个 1 GB tensor,如果某个算法连续把它从 HBM 读取 5 次,并多次写回中间结果,那么实际 memory traffic 可能远远超过 1 GB。所以:
这是三个不同的问题。
有了 FLOPs 和 memory traffic,我们就可以定义 Arithmetic Intensity:
\[ I = \frac{\text{FLOPs}} {\text{Bytes moved}} \]
它的单位通常是 FLOP/Byte。它回答的是:
每从 memory 搬 1 Byte 数据,这个算子能做多少浮点计算?
仍然看刚才的 BF16 addition。每个元素大约需要 1 FLOP 和 6 bytes memory traffic,因此:
\[ I \approx \frac{1}{6} \approx 0.17\text{ FLOP/Byte} \]
这是一个非常低的 arithmetic intensity。它意味着 GPU 花了很多精力把数据搬进搬出,却只做了很少的计算,因此很难充分利用计算单元。相反,如果一份数据加载以后能够在 registers、shared memory 或 cache 中被反复使用,那么同样的 HBM traffic 就可以支持更多 FLOPs,arithmetic intensity 也会更高。
不过这里有一个很重要的细节:
Arithmetic Intensity 不是只看数学公式就能完全确定的。
同一个数学计算,如果实现方式不同:
实际 memory traffic 都可能不同。
因此,我们后面说某个算子“高 arithmetic intensity”或“低 arithmetic intensity”,更多是在描述典型实现下的性能特征,而不是一个永远不变的标签。
Arithmetic intensity 最重要的用途,是把计算能力和 memory bandwidth 放进同一个模型里。
假设某个 GPU 的峰值计算吞吐量是 \(P_{\text{peak}}\),峰值 memory bandwidth 是 \(B_{\text{peak}}\)。对于 arithmetic intensity 为 \(I\) 的算子,memory system 最多能够支持的计算吞吐量是:
\[ P_{\text{memory}} = B_{\text{peak}}\times I \]
但实际吞吐量不可能超过 GPU 的峰值计算能力,因此可以写成:
\[ P \le \min (P_{\text{peak}}, B_{\text{peak}}I) \]
这就是 roofline model 最核心的公式。前半段 \(P=B_{\text{peak}}I\) 是一条斜线,表示性能受 memory bandwidth 限制;后半段 \(P=P_{\text{peak}}\) 是一条水平线,表示已经碰到计算能力上限。
假设一个 GPU 的峰值计算能力是 100 TFLOP/s,memory bandwidth 是 1 TB/s:
peak_compute = 100
memory_bandwidth = 1
intensity = np.logspace(-2, 4, 400)
performance = np.minimum(peak_compute, memory_bandwidth * intensity)
ridge_intensity = peak_compute / memory_bandwidth

fig = plt.figure(1)
ax = fig.add_subplot(1, 1, 1)
ax.loglog(intensity, performance, color='#EB6F10', linewidth=2, zorder=2)
ax.axhline(peak_compute, color='#0072B2', linestyle='--', zorder=1)
ax.axvline(ridge_intensity, color='#009E73', linestyle='--', zorder=1)
ax.scatter(ridge_intensity, peak_compute, color='black', s=36, zorder=3)
ax.set_xlabel('Arithmetic Intensity [FLOP / Byte]')
ax.set_ylabel('Performance [TFLOP / s]')
ax.grid(True, which='both', alpha=0.2)
legend = ['Roofline', 'Peak Compute', 'Ridge Intensity', 'Ridge Point']
ax.legend(legend, loc='upper left')
ax.set_title('Roofline Model')
plt.show()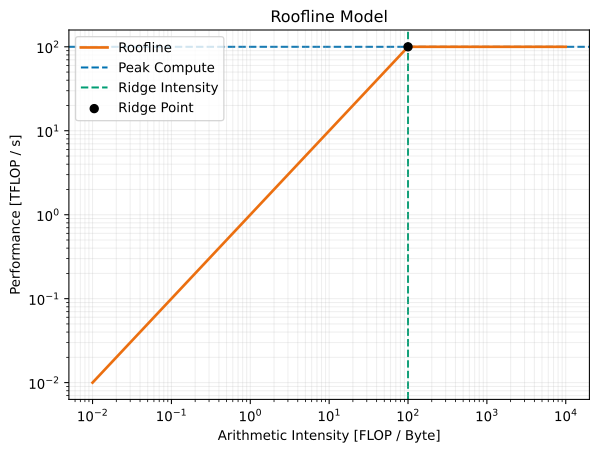
两条 roof 的交点叫作 ridge point,对应的 arithmetic intensity 为:
\[ I^* = \frac{P_{\text{peak}}} {B_{\text{peak}}} \]
在这个例子里:
\[ I^* = \frac{100\text{ TFLOP/s}} {1\text{ TB/s}} = 100\text{ FLOP/Byte} \]
因此:
这里真正重要的是这个判断方式:
不是问 FLOPs 高不高,而是问这些 FLOPs 对应了多少数据搬运。
大模型里最重要的一类计算是 General Matrix Multiply (GEMM)。对于:
\[ A\in\mathbb{R}^{M\times K}, \quad B\in\mathbb{R}^{K\times N} \]
计算量大约是 \(2MKN\)。
如果做一个非常理想化的估计,假设 \(A\) 和 \(B\) 都只从 HBM 读取一次,\(C\) 最终写回一次,每个元素占 \(s\) bytes,那么最低 memory traffic 大约是:
\[ s(MK + KN + MN) \]
于是 arithmetic intensity 近似为:
\[ I_{\text{GEMM}} \approx \frac{2MKN} {s(MK+KN+MN)} \]
如果进一步假设 \(M=N=K=n\),那么:
\[ I_{\text{GEMM}} \approx \frac{2n^3} {3sn^2} = \frac{2n}{3s} \]
注意这里的关键:
\[ I_{\text{GEMM}}\propto n \]
也就是说,矩阵变大以后,计算量按 \(O(n^3)\) 增长,而 I/O 只按 \(O(n^2)\) 增长。这意味着矩阵越大,同一份数据就越有机会被反复复用。
例如,在 BF16 下 \(s=2\) bytes。当 \(n=4096\) 时,按照上面的理想模型:
\[ I_{\text{GEMM}} \approx 1365\text{ FLOP/Byte} \]
这就是为什么大型 GEMM 往往是非常适合 GPU 的工作负载。GPU kernel 会把矩阵切成 tile,让加载进来的数据在 registers、shared memory 和 cache 中被反复利用,而不是每做一次乘法都重新访问 HBM。
当然,真实 GEMM 的 I/O 大小、数据复用率和调度比这个理想公式复杂得多。但核心思想是:
矩阵乘法的 FLOPs 很高,但它同时拥有很强的数据复用,所以计算量大并不等于效率低。
再看另一类 operator。
例如:
y = torch.relu(x)或者:
y = x + residual这类 elementwise operator 每个元素只做极少量计算,但仍然需要读入整个 tensor 并把结果写回。它们的 arithmetic intensity 通常很低,即使 GPU 理论上能够提供很高的 TFLOP/s,但因为每搬运一批数据,能做的计算太少,所以往往还没把算力用满,就先被 memory bandwidth 限制住了。
Normalization 也有类似特点。以 RMSNorm 为例:
\[ \operatorname{RMSNorm}(x) = \frac{x} {\sqrt{\frac{1}{d}\sum_{i=1}^{d}x_i^2 + \epsilon}} \odot \gamma \]
它除了 elementwise operation,还包含 reduction,需要完整扫描 activation,再完成平方、归约、归一化和缩放。虽然 FLOPs 远小于大型 GEMM,但它的数据访问和 reduction 开销并不会同步变小,因此在更容易表现出 memory-bound。
Optimizer 则更典型。以 AdamW 为例,一次参数更新需要访问:
并且还要更新 parameter、first moment 和 second moment。
它的 FLOPs 并不夸张,但 memory traffic 很大。所以 PyTorch 在 Adam/AdamW 中引入了 fused=True,把多个 elementwise operation 融合到一个 kernel 里,减少了中间 tensor 的读写和 HBM round trips,从而显著提高了实际吞吐量。
所以一个很重要的结论是:
低 FLOPs 不代表低运行时间。
如果 operator 大部分时间都在搬数据,那么继续减少几次乘法、加法,可能几乎没有收益。真正有效的优化反而可能是:
这也是为什么后面介绍 Triton 时,我们会反复看到 kernel fusion。
现在可以把 Transformer 中常见的 operator 放到同一个视角下理解。
| Operator | 典型计算特征 | 典型 Memory 特征 | 更容易受什么限制 |
|---|---|---|---|
| Large GEMM / Linear | FLOPs 很高,数据复用强 | tile 可以反复利用 | Compute |
| Elementwise Add / Activation | 每个元素只做少量计算 | 读写整个 tensor | Memory |
| LayerNorm / RMSNorm | 少量 elementwise + reduction | 扫描 activation | Memory / Reduction |
| AdamW Update | 每个参数做有限计算 | 反复读写 parameter / grad / states | Memory |
| Attention | Matmul 很重,但中间状态和实现方式影响很大 | 可能产生大量 HBM traffic | Shape / Implementation Dependent |
最后一行尤其值得注意。Attention 里确实包含 \(QK^T\) 和 \(PV\) 这样的矩阵乘法,但这并不意味着整个 attention 一定是 compute-bound。如果实现需要把巨大的 attention score matrix 写回 HBM,再重新读取做 softmax 和后续计算,那么 memory traffic 也会非常高。
因此,优化 attention 不一定需要减少数学上的 FLOPs。有时真正重要的是:
让中间结果尽量不要反复落到 HBM。
FlashAttention 的核心方向之一就是通过 tiling 和重新组织计算减少 HBM I/O。从 arithmetic intensity 的角度看,它的 FLOPs 与 attention 基本相近,但 memory traffic 明显下降,因此 arithmetic intensity 会明显提高。
这也说明性能优化并不只有减少 FLOPs 这一条路。另一条同样重要的路线是:
在不改变数学结果的前提下减少 memory traffic。
即使是同一种算子,也不一定永远处在同一种性能状态。例如:
\[ A \in \mathbb{R}^{32\times 128}, \quad B \in \mathbb{R}^{128\times 128} \]
相乘,和
\[ A \in \mathbb{R}^{4096\times 4096}, \quad B \in \mathbb{R}^{4096\times 4096} \]
相乘,都属于 GEMM,但硬件利用率可能完全不同。
小矩阵往往由于 parallelism 不够、kernel launch overhead 占比较高、Tensor Core tile 利用率不充分等因素,因此很难达到大型 GEMM 的执行效率。随着矩阵规模增大,GEMM 能够提供更多并行计算任务,同时带来更充分的数据复用和更高的硬件利用率,其性能也更容易接近计算吞吐上限。因此,“大型 GEMM 通常是 compute-bound”并不意味着“所有 GEMM 都是 compute-bound”。
Precision 同样会改变 compute 与 memory 之间的平衡。以 BF16 为例,相比 FP32,每个元素占用的字节数更少,因此相同规模的数据传输所需的 memory traffic 会降低。与此同时,许多 GPU 在 BF16 下还能利用 Tensor Core,获得显著高于 FP32 的峰值计算吞吐。因此,切换 precision 后,峰值计算性能 \(P_{\text{peak}}\) 和有效数据传输成本都会发生变化,进而改变 ridge point。
所以 compute-bound / memory-bound 不是一个一成不变的标签。更准确的说法应该是:
某个具体实现,在某个具体形状、精度和硬件条件上,更接近哪一种瓶颈。
需要注意的是,roofline 给的是一个上界模型。即使某个 GEMM 的 arithmetic intensity 足够高,理论上已经达到 compute-bound,也不代表它真的能够达到 \(P_{\text{peak}}\)。真实 kernel 还可能受到输入形状、设备等多种等因素影响。
因此,实际性能通常更适合写成:
\[ P_{\text{achieved}} = \frac{\text{Actual FLOPs}} {\text{Elapsed Time}} \]
例如,一个算子理论上可以达到 100 TFLOP/s,但实际只有 40 TFLOP/s。仅凭 roofline 并不能告诉我们剩下的差距具体来自哪里,但它可以先缩小问题范围:如果 arithmetic intensity 很低,就优先怀疑 memory 和 I/O;如果 arithmetic intensity 很高,则应该进一步检查 compute utilization。
这一步非常重要,因为很多性能问题并不是“理论 FLOPs 太高”或者“理论 memory traffic 太大”这么简单。一个算子可能理论上是 compute-bound,但因为输入形状太小导致 GPU 根本没有被充分占满;也可能理论上偏 memory-bound,但实际最大的瓶颈却来自频繁的 kernel launch 或 CPU 调度间隙。
所以理论分析更像是在告诉我们应该先怀疑什么,而不是直接给出最终结论。
到这里,可以把这一节压缩成一个简单的性能分析顺序。
看到一个 operator 时,先估计它的 FLOPs,再估计它大概需要搬多少数据,然后计算:
\[ I = \frac{\text{FLOPs}} {\text{Bytes}} \]
再把这个 arithmetic intensity 和当前硬件的 ridge point 比较。如果 \(I\) 很低,就更可能受到 memory bandwidth 限制;如果 \(I\) 很高,则说明它有机会进入 compute-bound 区域。但这里应该始终使用“更可能”和“有机会”这样的表述,因为 roofline 只能帮助我们建立性能假设,不能替代真实 profiling。
因此,一个完整的性能优化流程应该是:
下一节,我们就进入 Profiling。我们不再猜某个算子“可能很慢”,而是直接看一次真实运行时间到底花在哪里。